Domain vakuum-dämmung24.de kaufen?
Wir ziehen mit dem Projekt
vakuum-dämmung24.de um.
Sind Sie am Kauf der Domain
vakuum-dämmung24.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain vakuum-dämmung24.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **

Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
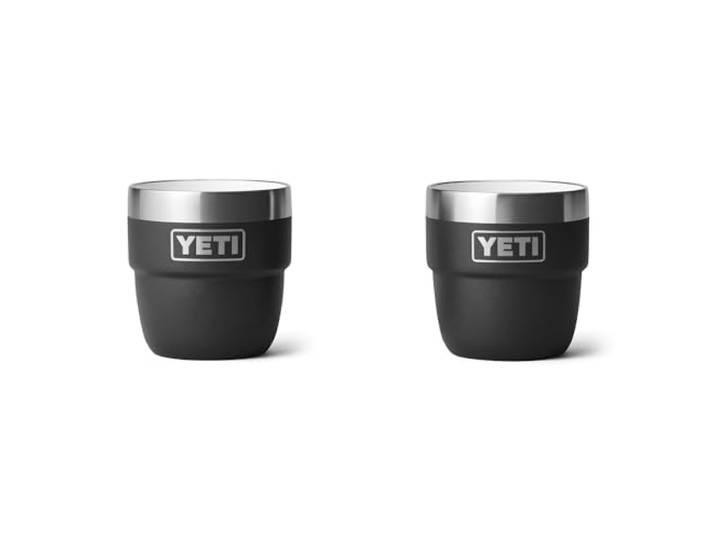
YETI Rambler Stapelbarer Becher mit 4 Unzen, Edelstahl, Vakuum-Isolierung, Espresso-/Kaffeebecher, 2er-Pack, MeerescremeYETI Rambler Stapelbarer Becher mit 4 Unzen, Edelstahl, Vakuum-Isolierung, Espresso-/Kaffeebecher, 2er-Pack, Meerescreme. Lassen Sie die Wildnis Ihrem Kaffeeritual nicht im Weg stehen. Die stapelbaren Rambler Becher mit einem Fassungsvermögen von 118 ml sind für konzentrierte Dosen konzipiert, die Ihnen helfen, sich auf das zu konzentrieren, was als nächstes passiert Barista-freundlich: Passend für die meisten Espressomaschinen und spülmaschinenfest, da niemand mehr Arbeit braucht Durasip-Keramikfutter: Kombiniert das klassische Aussehen und die Haptik von Keramik mit der Haltbarkeit, für die YETI bekannt ist. DuraSip Keramikfutter ist mit vakuumisoliertem 18/8-Edelstahl verschmolzen, wodurch es robust genug ist, um Tumbles zu nehmen und weiter zu trinken Stapelbar – Die Stapelbarkeit dieser Tassen macht sie ideal für Espressomaschinen, Campingküchen und darüber hinaus Schnapsglas – Nicht in Shots Espresso? Hmmmmm, vielleicht gibt es andere Getränke, die in Schnapsform kommen. Farbe:King Crab Orange109,54 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Tchibo - Buch »Das Wimmelbuch der Nachhaltigkeit«"Ein Suchbuch für die ganze Familie","Spielerischer Einstieg in das Thema, um schon die Jüngsten für eine Lebensweise zu begeistern","Liebevolle und detailreiche Illustrationen laden zum Entdecken ein","12 Seiten aus stabiler Pappe ‒ auch für kleinere Kinder geeignet"7,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Camelbak Podium Insulated Titanium 530ml Fahrradtrinkflasche mit Vakuum IsolierungMit der isolierten Trinkflasche von Camelbak hältst Du Dein Getränk beim Rennrad- und Gravelbike-Training länger kühl. Leicht und geschmacksneutral. Die Camelbak Podium Insulated Titanium Trinkflasche ist eine hochwertige Lösung für die zuverlässige Flüssigkeitsversorgung auf Rennrad und Gravelbike. Sie kombiniert ein klares, funktionales Design mit einer isolierten Bauweise, die Getränke länger auf Temperatur halten kann. Das Titanium-Design ist auf Langlebigkeit ausgelegt und unterstützt ein neutrales Trinkgefühl ohne unerwünschte Geschmacksübertragung. Durch ihre handliche Form lässt sich die Flasche gut greifen und einfach aus dem Flaschenhalter entnehmen. Sie eignet sich sowohl für längere Trainingseinheiten als auch für ausgedehnte Touren bei wechselnden Bedingungen. Als Teil des Camelbak Podium Systems fügt sie sich stimmig in bestehende Setups ein und bietet eine durchdachte Lösung für Fahrer, die Wert auf Qualität, Funktion und ein aufgeräumtes Gesamtbild legen. Produkteigenschaften Isolierte Trinkflasche für Rennrad und Gravelbike, unterstützt längere Temperaturstabilität bei warmen oder kühlen Bedingungen unterwegs. Robustes Design aus Titanium sorgt für langlebige Nutzung und geschmacksneutrales Trinken bei regelmäßigen Ausfahrten jederzeit. Isolierte Bauweise hilft, Getränke länger auf gewünschtem Temperaturniveau zu halten ohne technischen Aufwand beim Fahren. Angenehme Handhabung durch ergonomische Form erleichtert Trinken während Fahrtpausen oder moderatem Tempo auf dem Rad. Geeignet für sportliche Einsätze im Training oder Alltag als hochwertige Trinklösung mit klarer Funktion unterwegs. Konstruktion: Doppelwandige Vakuum-Isolierung Gewicht: 240g Fassungsvermögen: 530 ml Kältegarantie: 7 Stunden Optimierte Halteranpassung Kein qutechen notwendig BPA, BPS und BPF Frei Ultraleichtes Design High Flow Kappe auslaufsicher Universelles Kappensystem Material: Titan Abmessungen: 22,4 x 7,5 x 7,5 cm (Höhe x Durchmesser)74,50 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
YETI Rambler Stapelbarer Becher mit 4 Unzen, Edelstahl, Vakuum-Isolierung, Espresso-/Kaffeebecher, 2er-Pack, MeerescremeYETI Rambler Stapelbarer Becher mit 4 Unzen, Edelstahl, Vakuum-Isolierung, Espresso-/Kaffeebecher, 2er-Pack, Meerescreme. Lassen Sie die Wildnis Ihrem Kaffeeritual nicht im Weg stehen. Die stapelbaren Rambler Becher mit einem Fassungsvermögen von 118 ml sind für konzentrierte Dosen konzipiert, die Ihnen helfen, sich auf das zu konzentrieren, was als nächstes passiert Barista-freundlich: Passend für die meisten Espressomaschinen und spülmaschinenfest, da niemand mehr Arbeit braucht Durasip-Keramikfutter: Kombiniert das klassische Aussehen und die Haptik von Keramik mit der Haltbarkeit, für die YETI bekannt ist. DuraSip Keramikfutter ist mit vakuumisoliertem 18/8-Edelstahl verschmolzen, wodurch es robust genug ist, um Tumbles zu nehmen und weiter zu trinken Stapelbar – Die Stapelbarkeit dieser Tassen macht sie ideal für Espressomaschinen, Campingküchen und darüber hinaus Schnapsglas – Nicht in Shots Espresso? Hmmmmm, vielleicht gibt es andere Getränke, die in Schnapsform kommen. Farbe:King Crab Orange109,54 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Tchibo - Buch »Das Wimmelbuch der Nachhaltigkeit«"Ein Suchbuch für die ganze Familie","Spielerischer Einstieg in das Thema, um schon die Jüngsten für eine Lebensweise zu begeistern","Liebevolle und detailreiche Illustrationen laden zum Entdecken ein","12 Seiten aus stabiler Pappe ‒ auch für kleinere Kinder geeignet"7,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
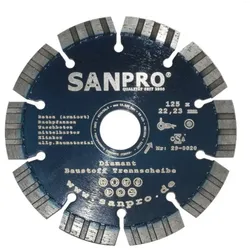
Diamanttrennscheibe Baustoff, 125 x 22,23 x 10 mmSANPRO Diamant Baustoff Trennscheibe (Beton, Klinker, Ziegel, ...). Profi-Diamant-Trennscheibe für den täglichen Baustelleneinsatz. Entwickelt für Winkelschleifer Ø 125 - 230 mm. Laserschweißung der Diamantsegmente. Hoher Diamantanteil in den Segmenten. 10 mm Turbo-Segmente vermindern die Seitenreibung und ermöglichen einen schnellen Schnitt. Optimal für Beton mit und ohne Armierung, Altbeton, Waschbeton, Klinker (mittelhart), Dachpfannen (mittelhart), allg. Baumaterial.3,84 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.